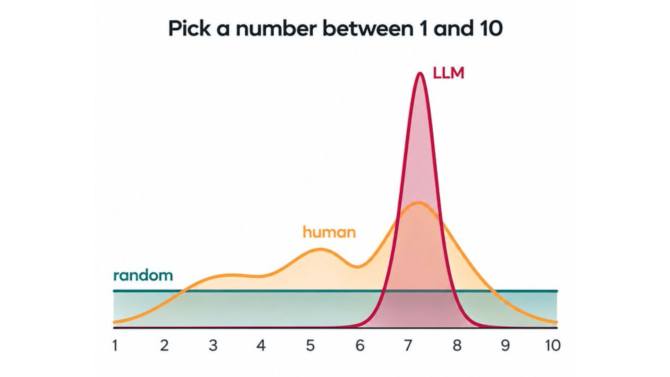
Je již dlouhou dobu známo, že velké jazykové modely (LLM) nejsou vhodné k vybírání náhodných čísel či silných hesel. Poněkud překvapivé je, že se doposud nic nezměnilo. Adam Wasserman minulý týden zveřejnil hezký graf, podle kterého LLM na dotaz „vyber číslo mezi 1 a 10“ (případně anglicky „pick a number between 1 and 10“) vždy odpoví 7.
Důvodem je, že lidské odpovědi poněkud preferují odpověď 7 a LLM naučené na lidských zdrojích tuto preferenci výrazně zesilují. Lidská preference je prý založena na několika faktech. Zaprvé, lidé nemají rádi hraniční hodnoty (1, 10). Zadruhé, přesná polovina také není častá (5). Také sudá čísla jsou prý méně oblíbená (2, 4, 6, 8). Zbývá tedy 3, 7 a 9. Z nich 3 a 9 jsou blíže hraničních hodnot.
V malém experimentu na duck.ai mi všech šest dostupných LLM odpovědělo na český i anglický dotaz vždy 7. Kde to bylo možné, měl jsem zapnutý „reasoning“. Konkrétně se jedná o to tyto LLM: GPT-6, GPT-5.4 mini, Claude Haiku 4.5, Mistral small 4, gpt-oss 120B a Gemma 4 31B.
Více detailů k problému generování náhodných čísel pomocí LLM můžete nalézt například v loňském článku. Rozebírá se zde vliv jazyka otázky, vliv nastavené teploty (náhodnosti, to ale asi změníte jen v lokálním modelu) a vliv zvoleného intervalu čísel.


 ČLÁNKY DO MAILU